Artigo aceito8WoSI² · 12JIHC'26Talca, Chile · 10 nov. 2026
Skills curadas para apoio inteligente e sensível ao contexto em UX e acessibilidade no iOS.
O EvenBetter transforma o HIG, a documentação de acessibilidade da Apple e a WCAG 2.2 em skills que o agente de IA segue passo a passo. Num estudo com dez devs iOS, a usabilidade percebida ficou em 79,5.
- 1Faculdade de Computação e Informática, Universidade Presbiteriana Mackenzie, São Paulo
- 2Programa de Pós-Graduação em Computação Aplicada, Faculdade de Computação e Informática, Universidade Presbiteriana Mackenzie, São Paulo
skills instaláveis
na versão do artigo
cláusulas para iOS
domínios de diretrizes
devs iOS no estudo
de SUS médio
escala de 0 a 100
achados que todos leram no relatório
01 · Contexto
O agente preenche as lacunas sozinho.
Quando o pedido não diz quem vai usar, como se navega e que regras valem, o agente completa o resto com suposições plausíveis. Em acessibilidade, a omissão vira código antes de alguém pensar nela.
O pedidoPlaneje um app para organizar a limpeza da casa.
Sem skills, o agente decide sozinho: quatro decisões implícitas e nenhuma pergunta.
Produto
SupôsUma lista de tarefas para uma pessoa só.
Navegação
SupôsDuas abas, Tarefas e Cômodos.
Persistência
SupôsTudo salvo só no aparelho.
Acessibilidade
SupôsNão entrou na conversa.
perguntas
antes do código
O agente parte direto para a implementação. As quatro decisões ficam escondidas no código.
Exemplo ilustrativo do caso interno descrito no artigo. As perguntas reais variam com o pedido.
95,9%
das home pages do WebAIM Million 2026 tinham falhas de WCAG detectáveis. [4]
69,2% × 31,3%
dos erros de leitor de tela em apps: uma auditoria com LLM contra um verificador muito usado. [9]
84%
dos devs usam ou pretendem usar IA, mas confiam pouco na precisão do que ela entrega. [5]
A aposta
Uma skill é um pacote versionado que diz quando se aplica, o que perguntar, o que consultar, que passos seguir e como entregar o resultado [6, 7]. As do EvenBetter são curadas antes, a partir das fontes oficiais. O agente não inventa o procedimento enquanto trabalha.
+16,6
pontos percentuais na taxa média de acerto com skills curadas no SkillsBench. Skills geradas pelo próprio agente ficaram abaixo de não usar nenhuma [15].
RQ1
Como skills curadas podem codificar diretrizes de UX e acessibilidade como conhecimento procedural para agentes que entendem o contexto, no desenvolvimento SwiftUI?
Respondida pelo design do artefatoRQ2
Como devs iOS percebem, entendem e usam um fluxo com skills para planejar apps e auditar acessibilidade?
Respondida pelo estudo com dez devs02 · Humano no comando
Você decide antes de o agente agir.
Automação alta e controle humano alto podem andar juntos [23]. No EvenBetter, a direção, as restrições e os critérios de aceite vêm de quem desenvolve. Escolha um modo para comparar.
01
Direção e critérios
agentededuzida de um prompt curto02
Pesquisar
agente03
Decidir
agente04
Produzir
agente05
Revisar
vocêaprova o resultado
A IA pesquisa, decide e produz. A pessoa só aprova no fim. Essa revisão é fácil de pular e, mesmo obrigatória, piora com o tempo: quem vigia uma automação que quase sempre acerta passa a notar menos erros. [24]
Alta automação e alto controle
automação →
controle humano →
03 · Requisitos
Cinco requisitos guiaram o design.
O sistema não substitui o julgamento profissional nem certifica acessibilidade. Ele adapta a interação à tarefa e deixa o contexto à vista.
Requisito 1 de 5
Consciência de contexto
O comportamento do agente muda conforme a tarefa: planejar, analisar, validar ou corrigir.
- Uma skill para cada etapa
- Cada skill com seu contrato de saída
- O agente pergunta o que falta
04 · Arquitetura
Mesmo modelo, procedimento diferente.
Cada etapa do fluxo é uma skill com seu próprio contrato de saída. Escolha uma etapa para ver o que o agente lê e o que escreve.
Lê
Sua intenção
um pedido curto
Projeto SwiftUI
arquivos, telas e componentes
Corpus
49 cláusulas com fonte
Relatório
salvo em .evenbetter/
Agente de IA
Claude Code · Codex
evenbetter-analyze
Liga cada problema a um arquivo, uma linha e uma cláusula. Achado que não se confirma na fonte oficial sai.
No relatório: cria a lista de achados
Escreve
Perguntas para você
opções fechadas
Plano e tarefas
com critérios de aceite
Relatório HTML
achados com evidência
Correções no código
só os ajustes técnicos
A separação é proposital.
Numa conversa solta, "analise a acessibilidade" logo vira "corrija tudo". Aqui, cada passagem entre planejar, analisar, validar e corrigir fica explícita nos artefatos.
Uma memória fora do modelo.
O contexto do modelo é temporário. Planos com decisões e relatórios com evidência ficam versionados e podem ser reabertos e revisados.
Cinco camadas de contexto
Contexto, aqui, não é localização nem perfil. É a etapa da tarefa, o código em análise, as diretrizes e as decisões que ainda dependem de alguém.
- 1TarefaDefine qual skill entra e qual contrato de saída vale.
- 2ProjetoAncora a resposta nos arquivos, telas e componentes SwiftUI e nos artefatos gerados.
- 3DiretrizesLimita o julgamento do agente às cláusulas curadas.
- 4HumanoGuarda as respostas de quem desenvolve e o que continua em aberto.
- 5ExecuçãoConsidera o ambiente: terminal, descoberta do plugin e permissões.
Procedural, não preditivo
Nenhum perfil escondido.
O EvenBetter não personaliza por variáveis opacas. Ele escolhe o procedimento que serve à situação. Quando a correção depende da intenção do produto, a dúvida vira uma pergunta para você.
Por que skills, e não um app
As duas primeiras versões pesavam para adotar, e cada análise completa dependia de uma execução cara de LLM de ponta a ponta.
Como skills, o conhecimento roda no Claude Code ou no Codex, com o login, as permissões e as ferramentas que você já usa.
05 · Cláusulas
Como uma diretriz vira cláusula.
Entra no corpus se for
Orientação só aspiracional vira justificativa de outra cláusula ou fica de fora.
ID estável
A11Y-UI-001
Label meaningful images and icon buttons
Severidade e dimensão
erroruiios
Fonte e data
Retrieved 2026-05-02
Verificação
Flag Image(systemName:), image-only Button, toolbar icon controls, or custom icon controls that lack a visible text label and lack .accessibilityLabel(...).
Justificativa
VoiceOver users need a meaningful name for non-text controls and images.
Código correto
Button(action: close) {
    Image(systemName: "xmark")
}
.accessibilityLabel("Close")
Cláusulas por domínio
ErroAvisoInfo
- Tipografia8
- Cor e temas6
- Componentes e padrões7
- Layout e interação9
- Feedback tátil4
- Navegação e fluxo7
- Acessibilidade8
IDs que não mudam
Quando a Apple atualiza uma página do HIG, a cláusula é revisada no histórico. O ID fica, e os achados antigos continuam rastreáveis.
Limiares preservados
Quando a fonte define um número, como o tamanho mínimo de toque ou a razão de contraste, a cláusula guarda o número.
06 · Relatório
O relatório é o artefato central.
Em vez de um veredito fechado, quem desenvolve recebe evidência para conferir. Este é o relatório que os participantes leram no estudo.
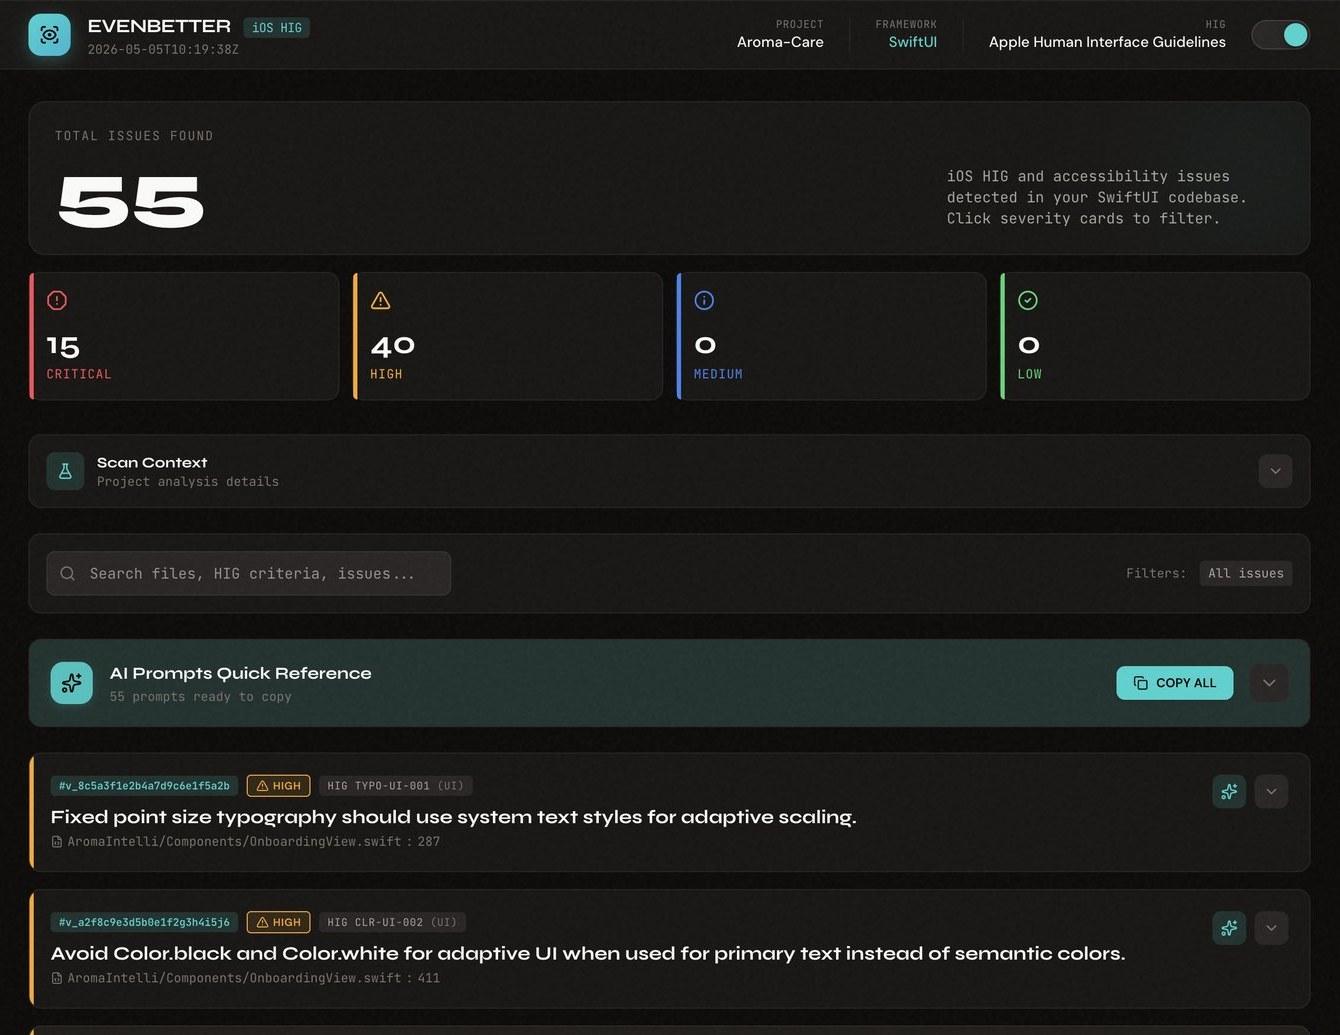
Toque num número para ampliar
Todo achado traz
- Arquivo e linha
- Evidência
- Domínio
- Severidade
- Cláusula do corpus
- Impacto esperado
- Correção mínima
- Correção recomendada
- Prompt de correção
Cada achado precisa citar uma fonte oficial da plataforma. O que não dá para confirmar é descartado em vez de ir para o relatório.
No corpus
Erro
Aviso
Info
No relatório
Crítica
Alta
Média
Baixa
Um aviso vira alta quando a regra é firme e o impacto é claro, e média quando o sinal no código é mais fraco. A validação reajusta a severidade de cada achado.
07 · Método
Como avaliamos.
- 1Curardiretrizes da Apple, da WCAG e da literatura
- 2Modelarskills e cláusulas rastreáveis
- 3Implementarnos agentes, como plugins
- 4Verificaro comportamento das skills, internamente
- 5Avaliarcom devs iOS, de forma exploratória
10 participantes
- 4Menos de 1 ano de iOS
- 31 a 2 anos
- 33 a 5 anos
Todos maiores de 18 anos e com experiência em SwiftUI, recrutados por conveniência. As cores mostram contagens, não acompanham pessoas.
Uma sessão
≈ 30 min
- O que avaliou
- Se a pessoa entende a sequência analisar e validar e consegue ler o relatório.
- Dados
- Sequência observada, leitura do relatório e prompt de correção escolhido.
- Material
- App Aroma Care, de busca de óleos essenciais, e o relatório HTML gerado para ele
O ambiente já vinha pronto, com repositório, dependências, agente e plugin instalados. Assim, a sessão focou na interação.
08 · Resultados
Usabilidade em 79,5 e um relatório que todos leram.
Os dez participantes responderam ao SUS depois das tarefas guiadas. Mais abaixo está o que aconteceu em cada etapa da sessão.
System Usability Scale · 0 a 100
Uma bolinha por participante
- Média
- 79,5
- Mediana
- 81,25
- Desvio padrão
- 15,1
- Faixa
- 57,5 a 100
A média fica acima dos cerca de 70 pontos de uma avaliação do SUS em larga escala [20]. Na escala de adjetivos de Bangor e colegas [21], foram quatro notas Excelente, três Bom e três OK.
Os três OK vieram de quem tinha pouca experiência com skills. Três dos quatro Excelente já tinham usado skills no Claude Code, e um participante sem experiência com agentes também chegou a Excelente. A amostra não permite inferência.
5de 10
elogiaram a tipografia e a hierarquia
4de 10
usaram o chat do site para escolher uma skill
Funcionou
Entenderam a proposta e encontraram as skills.
Atrito
O vocabulário: skill curada, site, marketplace, plugin e agente se confundiam no começo.
Como descreveram o relatório
- direto
- útil para decidir por onde começar
- um artefato para aprender
As respostas abertas elogiaram a utilidade das correções e a integração com ferramentas que as pessoas já usam.
De onde veio o atrito
Quem tinha menos experiência com agentes atribuiu o atrito ao Claude Code, ao terminal e à expectativa de uma experiência de IDE, como a do Xcode.
Site, plugin, terminal, agente e relatório apareceram na mesma sessão, então o estudo não separa o que veio de cada parte.
09 · Implicações
Quatro lições para quem cria ferramentas com agentes.
O pedido abre a conversa.
Ferramentas com agentes devem tratar o prompt como o começo da interação, não como uma especificação completa.
Relatório é para gente ler.
A saída de uma auditoria deve ser um artefato legível, com evidência e severidade à vista.
A incerteza aparece no fluxo.
Separar análise de validação e perguntar quando a correção depende da intenção do produto deixa a dúvida visível.
O onboarding faz parte do sistema.
Nomes, exemplos, documentação e integração com a IDE decidem se as pessoas conseguem aproveitar as skills.
10 · Limites
O que o estudo não mostra.
Os resultados não medem a precisão das auditorias. Mostram que skills curadas conseguem estruturar a interação e manter o julgamento humano visível.
Validade interna
O ambiente veio pronto. Ninguém instalou o framework do zero nem rodou a análise completa na sessão.
Validade de construto
A tarefa mediu se as pessoas entendiam o relatório, não se cada achado estava tecnicamente certo.
Validade externa
Dez participantes recrutados por conveniência, todos com SwiftUI, avaliando um único app.
Confiabilidade
Mesmo com as skills fixas, versões futuras dos modelos podem gerar saídas diferentes.
Sem comparação
Não houve linha de base, então os ganhos ainda não podem ser creditados às skills em vez de a um agente sem elas.
Próximos passos
- i
Comparar com agentes sem skills curadas e com verificadores determinísticos nos mesmos apps, com métricas objetivas.
- ii
Medir a precisão dos achados com especialistas em acessibilidade: verdadeiros e falsos positivos e cobertura.
- iii
Avaliar vários apps iOS, com interfaces diferentes, equipes maiores e ambientes industriais.
- iv
Medir a eficácia das correções e o uso ao longo do tempo, inclusive se a validação ativa mantém a detecção de erros. [24]
11 · Ética e código
Aprovado, aberto e declarado.
Aprovação ética
Comitê de Ética em Pesquisa da Universidade Presbiteriana Mackenzie. Pesquisa de risco mínimo.
- CAAE
- 96317526.0.0000.0084
- Parecer
- 8.376.386
Código aberto
Os plugins, as skills e o corpus de 49 cláusulas estão públicos no GitHub.
MelloBirkan/EvenBetterFrameworkUso de IA generativa
Ferramentas de IA generativa ajudaram na redação, na revisão e na organização do texto. Os autores definiram o problema, o método, as fontes e a leitura dos dados, e respondem pelo texto final.
12 · Como citar
Use o EvenBetter na sua pesquisa.
O artigo foi aceito no 8° Workshop en Sistemas Interactivos Inteligentes, parte das 12° Jornadas Iberoamericanas de Interacción Humano-Computadora, em Talca, no Chile.
@inproceedings{birkan2026evenbetter,
  title     = {Curated Agent Skills for Context-Aware Intelligent Support in iOS UX and Accessibility},
  author    = {Gonzatto Birkan, Marcello and Brazolin Flauto, Daniela and Farinazzo Martins, Val{\'e}ria},
  booktitle = {8{\textdegree} Workshop en Sistemas Interactivos Inteligentes (8WoSI{\textsuperscript{2}}), 12{\textdegree} Jornadas Iberoamericanas de Interacci{\'o}n Humano-Computadora (12JIHC'26)},
  address   = {Talca, Chile},
  year      = {2026},
  note      = {Accepted paper}
}13 · Referências
As 25 referências do artigo.
- [1]World Wide Web Consortium (W3C): Web Content Accessibility Guidelines (WCAG) 2.2. W3C Web Accessibility Initiative (2024) www.w3.org/TR/WCAG22
- [2]Apple: Human Interface Guidelines. Apple Developer, last accessed 2026/08/28 developer.apple.com/design/human-interface-guidelines
- [3]Apple: Accessibility. Apple Developer, last accessed 2026/08/28 developer.apple.com/accessibility
- [4]WebAIM: The WebAIM Million: The 2026 Report on the Accessibility of the Top 1,000,000 Home Pages. WebAIM (2026) webaim.org/projects/million
- [5]Stack Overflow: Stack Overflow Developer Survey 2025. Stack Overflow (2025) survey.stackoverflow.co/2025/ai
- [6]Anthropic: Equipping agents for the real world with Agent Skills. Anthropic Engineering (2025) www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
- [7]Agent Skills: Agent Skills Specification (2025) agentskills.io/specification
- [8]Nielsen, J.: The Articulation Barrier: Prompt-Driven AI UX Hurts Usability. UX Tigers (2023) www.uxtigers.com/post/ai-articulation-barrier
- [9]Zhong, M., Chen, R., Chen, X., Fogarty, J., Wobbrock, J.O.: ScreenAudit: Detecting Screen Reader Accessibility Errors in Mobile Apps Using Large Language Models. In: Proceedings of CHI 2025. ACM (2025)
- [10]Fathallah, N., Hernandez, D., Staab, S.: AccessGuru: Leveraging LLMs to Detect and Correct Web Accessibility Violations in HTML Code. In: Proceedings of the 27th International ACM SIGACCESS Conference on Computers and Accessibility. ACM (2025)
- [11]Mehralian, F., Barik, T., Nichols, J., Swearngin, A.: Automated Code Fix Suggestions for Accessibility Issues in Mobile Apps. arXiv preprint arXiv:2408.03827 (2024) arxiv.org/abs/2408.03827
- [12]Yuan, M., Chen, J., Xing, Z., Quigley, A., Luo, Y., Luo, T., Mohammadi, G., Lu, Q., Zhu, L.: DesignRepair: Dual-Stream Design Guideline-Aware Frontend Repair with Large Language Models. arXiv preprint arXiv:2411.01606 (2024) arxiv.org/abs/2411.01606
- [13]Lewis, P., et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. In: NeurIPS 2020. Curran Associates (2020)
- [14]Liu, N.F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P.: Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics 12, 157–173 (2024)
- [15]Li, X., et al.: SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks. arXiv preprint arXiv:2602.12670 (2026) arxiv.org/abs/2602.12670
- [16]Hevner, A.R., March, S.T., Park, J., Ram, S.: Design Science in Information Systems Research. MIS Quarterly 28(1), 75–106 (2004)
- [17]Peffers, K., Tuunanen, T., Rothenberger, M.A., Chatterjee, S.: A Design Science Research Methodology for Information Systems Research. Journal of Management Information Systems 24(3), 45–77 (2007)
- [18]van Someren, M.W., Barnard, Y.F., Sandberg, J.A.C.: The Think Aloud Method: A Practical Guide to Modelling Cognitive Processes. Academic Press, London (1994)
- [19]Brooke, J.: SUS: A Quick and Dirty Usability Scale. In: Jordan, P.W., Thomas, B., Weerdmeester, B.A., McClelland, I.L. (eds.) Usability Evaluation in Industry, pp. 189–194. Taylor & Francis, London (1996)
- [20]Bangor, A., Kortum, P.T., Miller, J.T.: An Empirical Evaluation of the System Usability Scale. International Journal of Human-Computer Interaction 24(6), 574–594 (2008)
- [21]Bangor, A., Kortum, P., Miller, J.: Determining What Individual SUS Scores Mean: Adding an Adjective Rating Scale. Journal of Usability Studies 4(3), 114–123 (2009)
- [22]Braun, V., Clarke, V.: Using Thematic Analysis in Psychology. Qualitative Research in Psychology 3(2), 77–101 (2006)
- [23]Shneiderman, B.: Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy. International Journal of Human-Computer Interaction 36(6), 495–504 (2020)
- [24]Parasuraman, R., Manzey, D.H.: Complacency and Bias in Human Use of Automation: An Attentional Integration. Human Factors 52(3), 381–410 (2010)
- [25]High-Level Expert Group on Artificial Intelligence: Ethics Guidelines for Trustworthy AI. European Commission, Brussels (2019)
Experimente o que o artigo descreve.
Instale o plugin no Claude Code ou no Codex e rode a primeira auditoria.